17 окт. 2026 г. · Victor Slompo
90% реальной работы всё ещё ускользает от бенчмарков
Красивый бенчмарк сам по себе не показывает, какую работу ИИ действительно должен делать
Изображения — оригинальная карусель из Instagram на португальском языке.
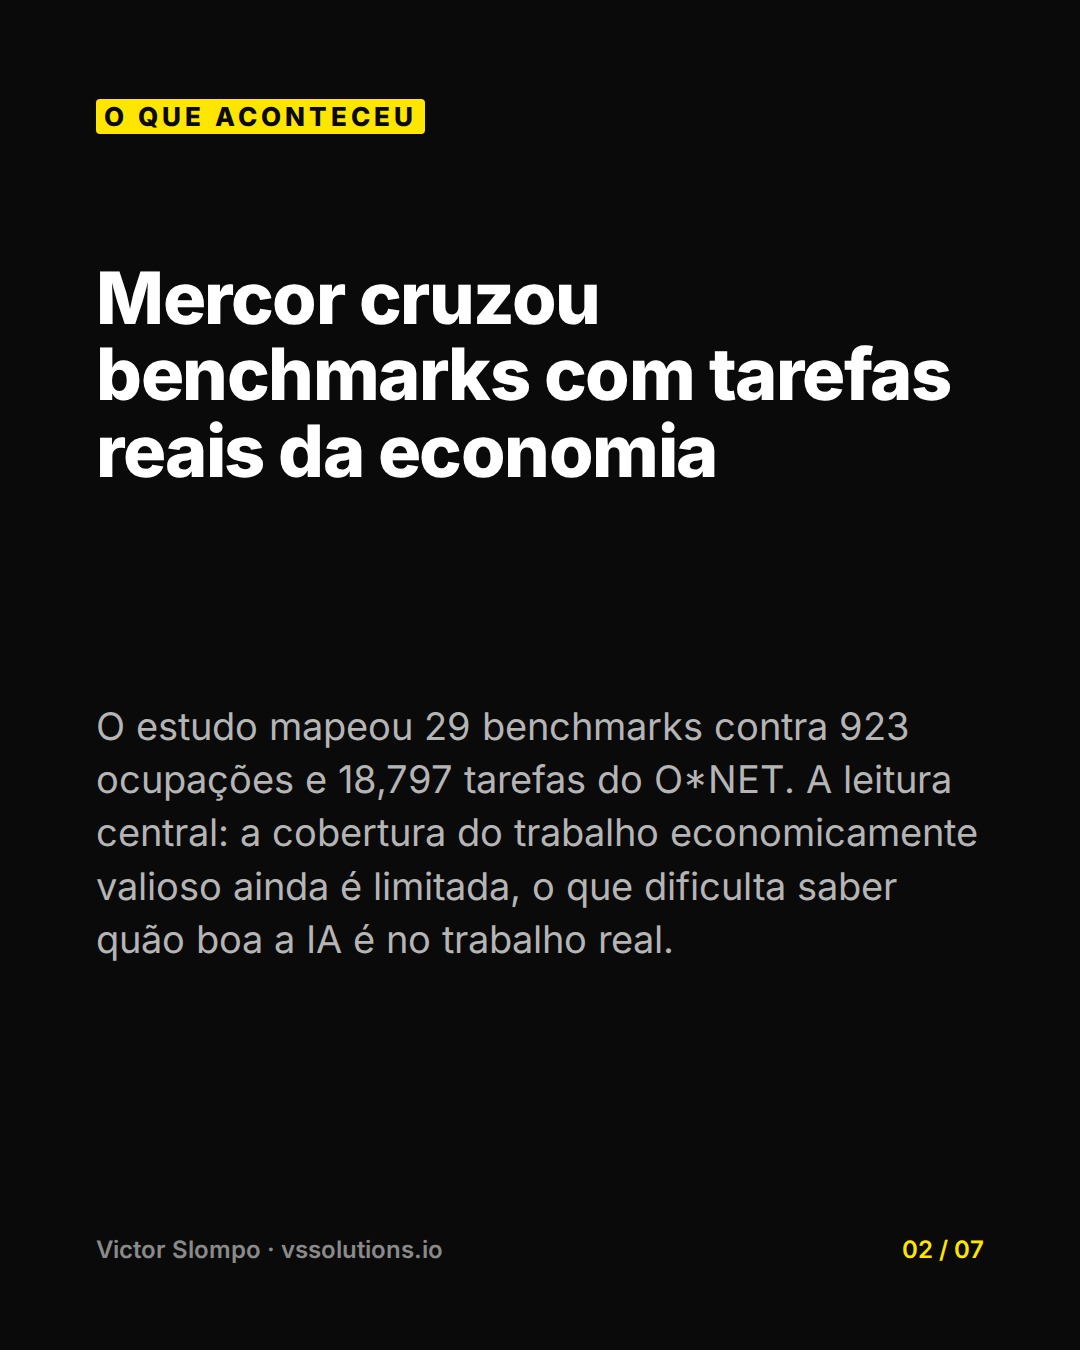
ЧТО ПРОИЗОШЛО
Mercor сопоставил бенчмарки с реальными задачами экономики
В исследовании сопоставили 29 бенчмарков с 923 профессиями и 18 797 задачами из O*NET. Главный вывод: охват экономически ценной работы по-прежнему ограничен, и из-за этого трудно понять, насколько ИИ хорош в реальной работе.
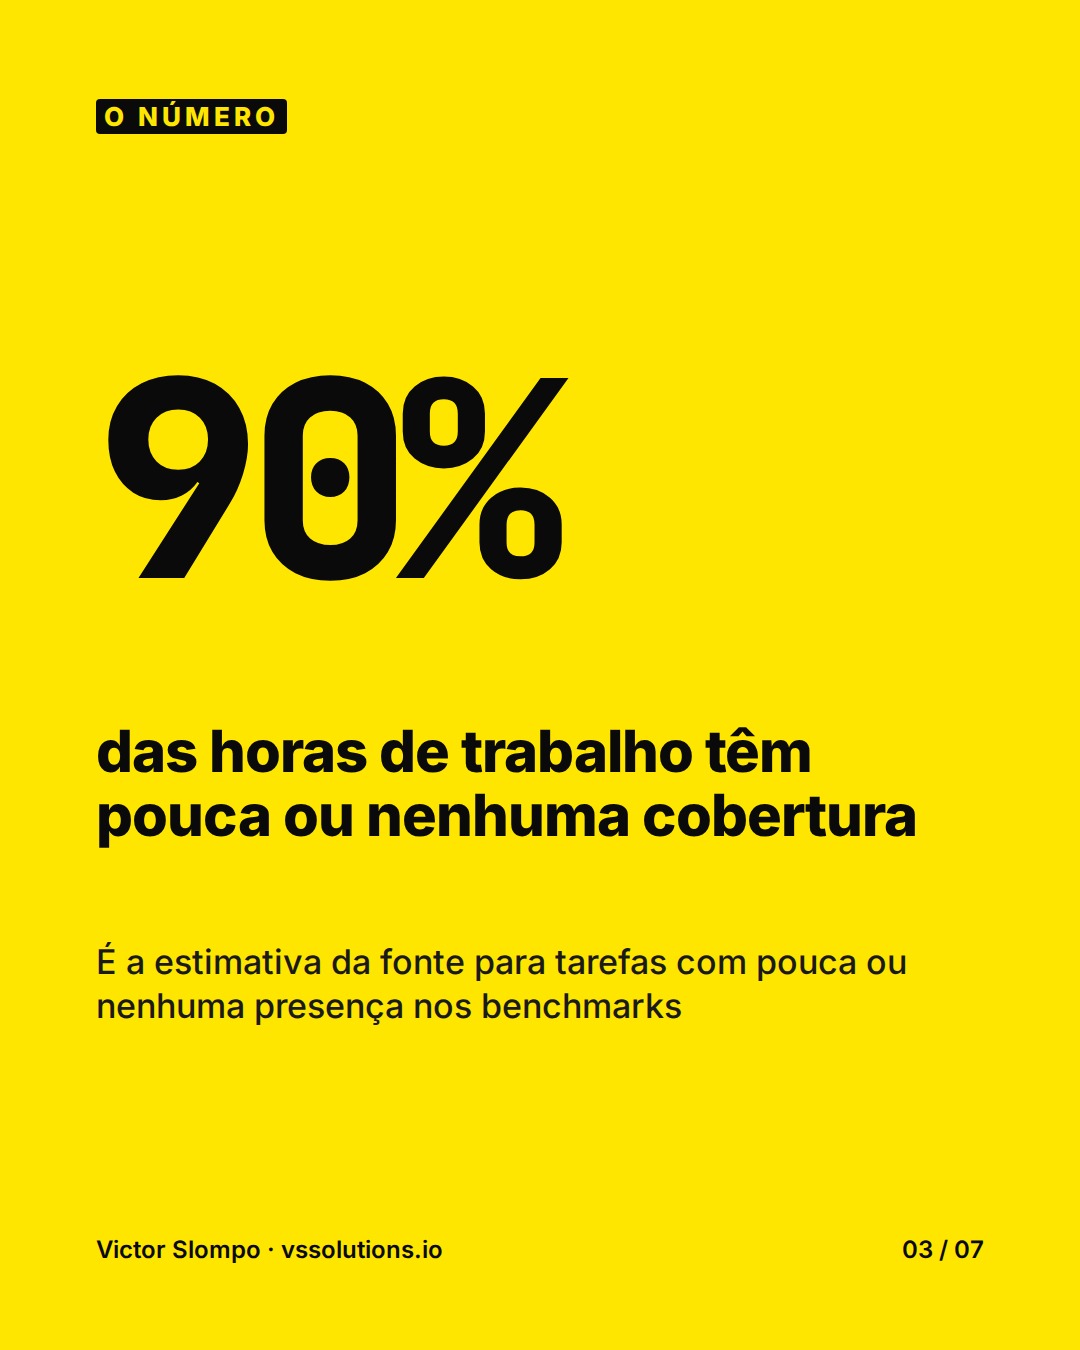
ЦИФРА
90%
рабочих часов почти не охвачены или совсем не охвачены
Это оценка источника для задач, которые почти не представлены или совсем не представлены в бенчмарках
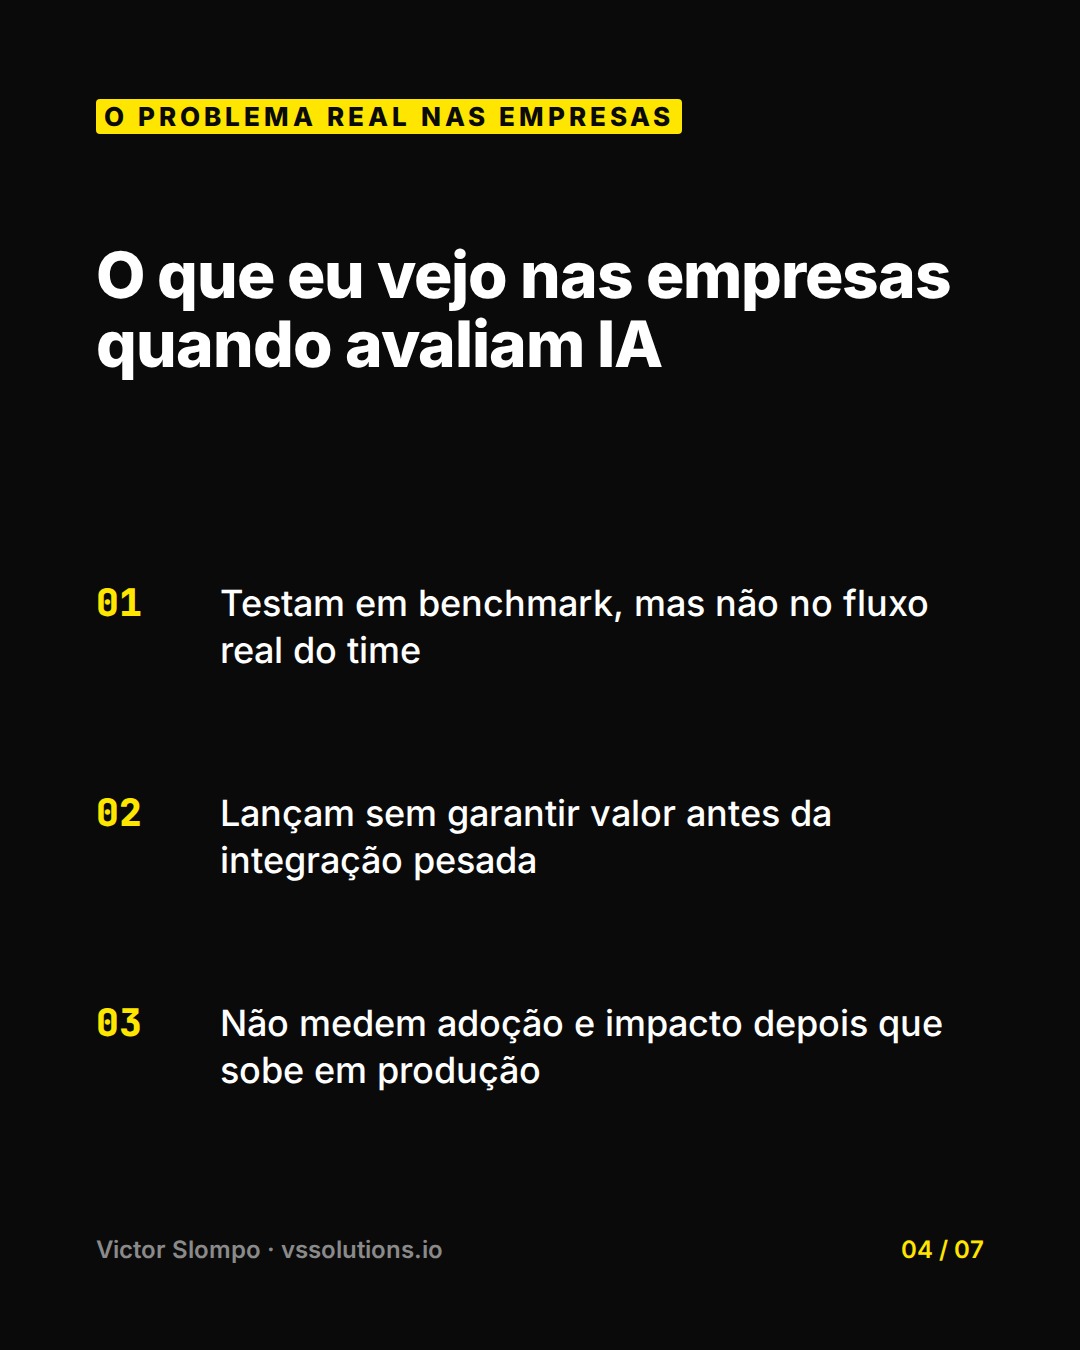
РЕАЛЬНАЯ ПРОБЛЕМА В КОМПАНИЯХ
Что я вижу в компаниях, когда они оценивают ИИ
- 01Тестируют на бенчмарке, но не в реальном рабочем процессе команды
- 02Запускают без подтверждённой ценности до тяжёлой интеграции
- 03Не измеряют внедрение и эффект после выхода в прод
Я УЖЕ ЭТО РЕШАЛ
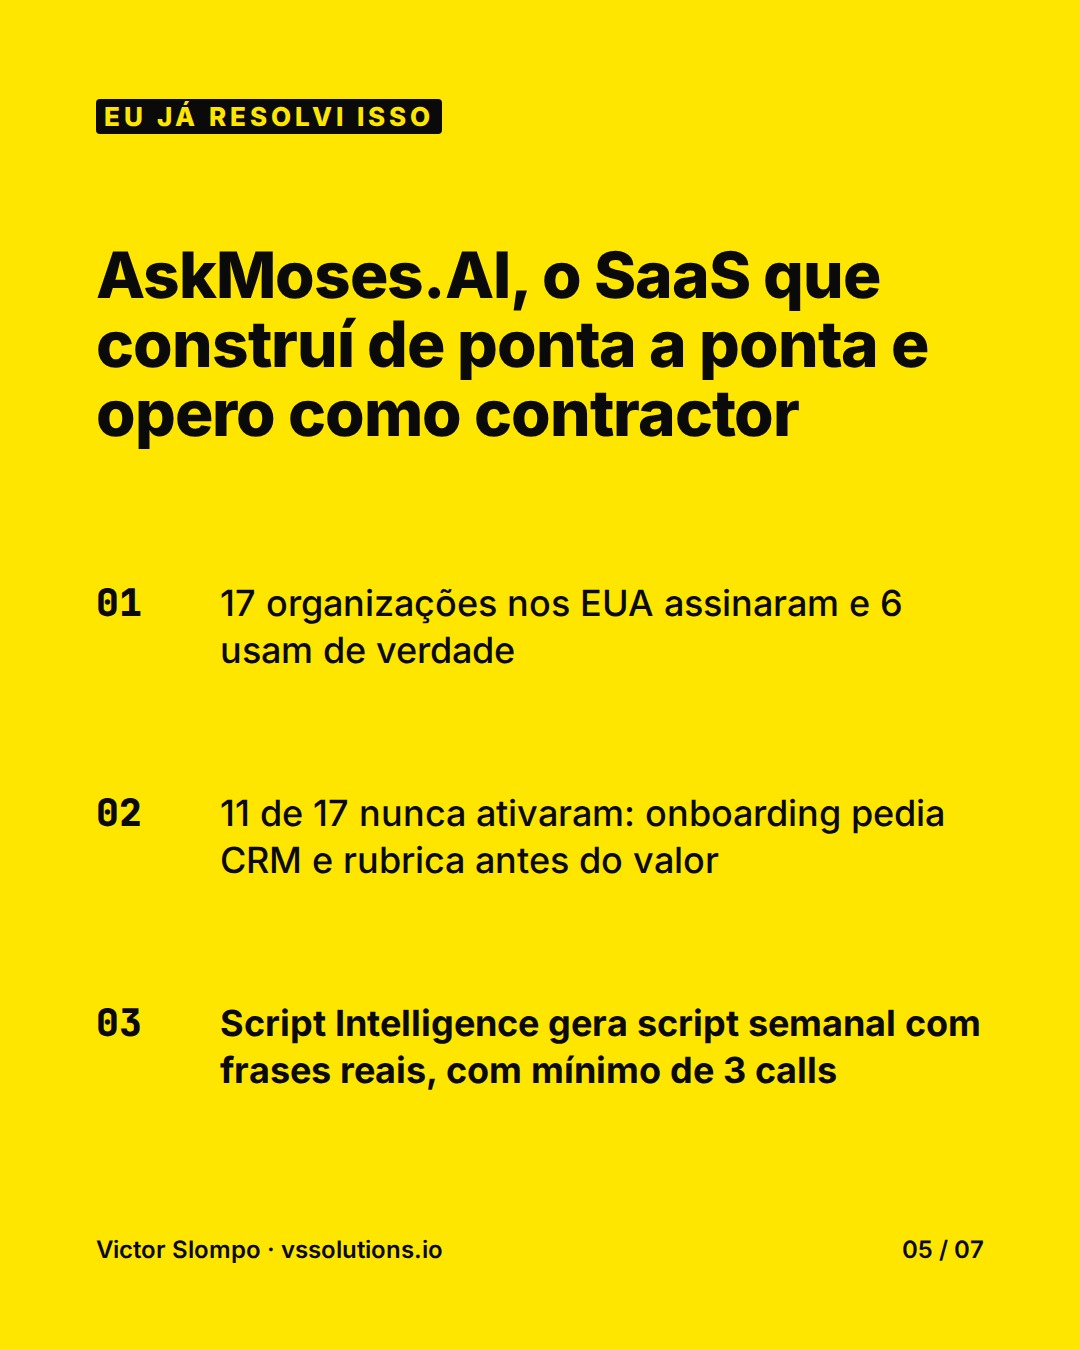
AskMoses.AI — SaaS, который я построил с нуля и веду как contractor
- 0117 организаций в США подписались, и 6 реально используют продукт
- 0211 из 17 так и не активировались: онбординг требовал CRM и rubric до получения ценности
- 03Script Intelligence каждую неделю генерирует скрипт с реальными фразами, минимум по 3 calls
МОЙ ВЫВОД
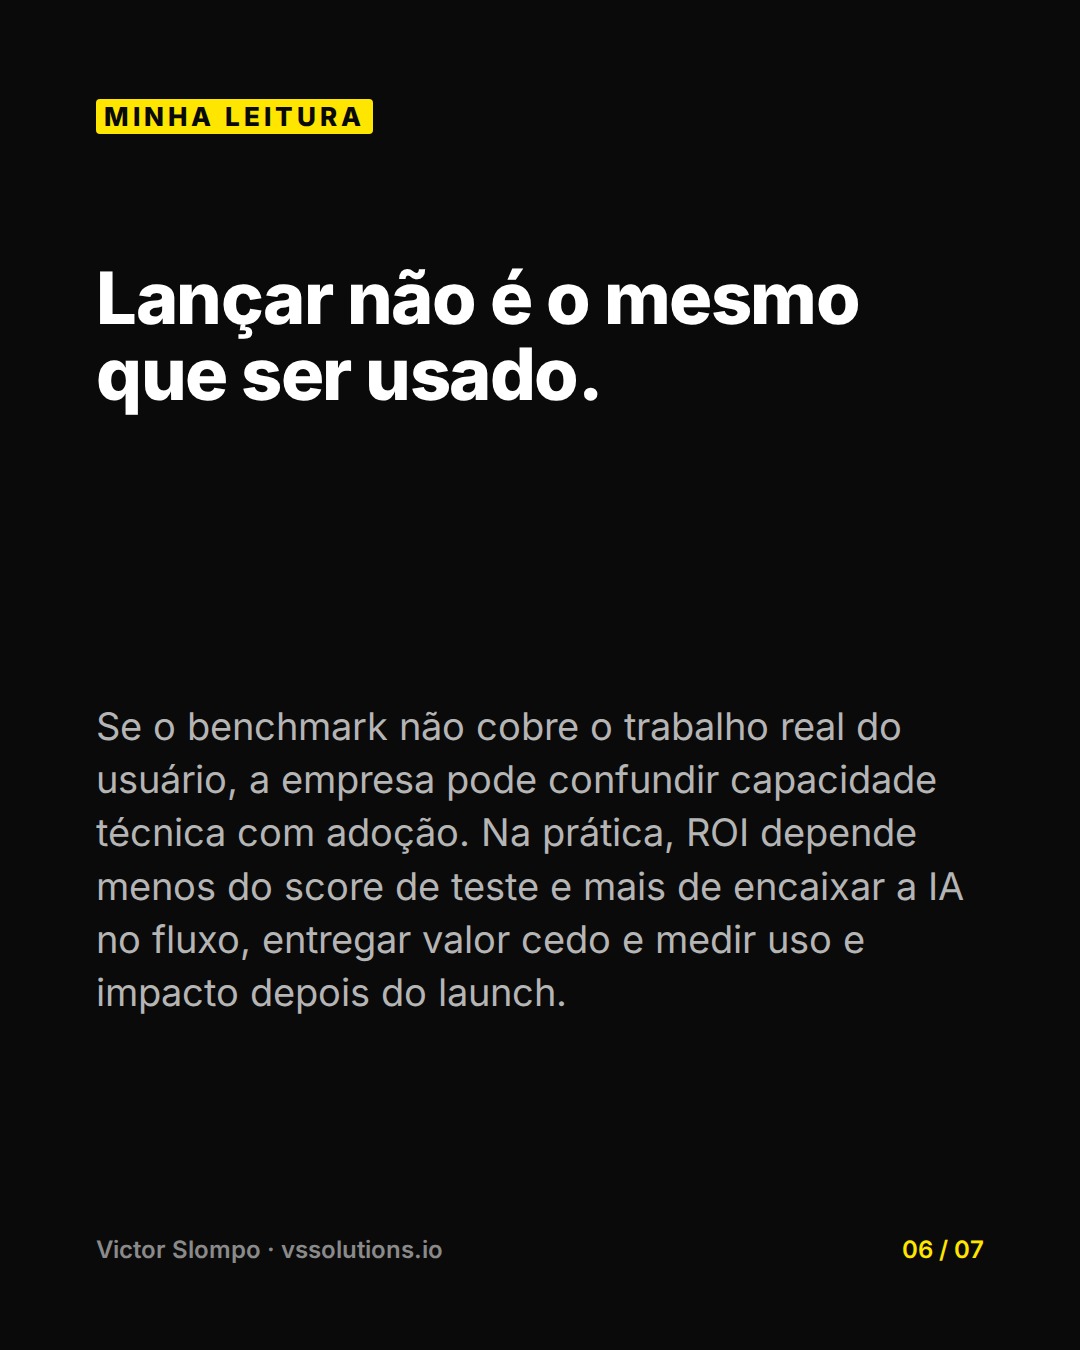
Запустить — не значит, что будут пользоваться.
Если бенчмарк не покрывает реальную работу пользователя, компания может перепутать технические возможности с внедрением. На практике ROI меньше зависит от тестового score и больше — от того, насколько ИИ встроен в рабочий процесс, как рано он даёт ценность и измеряются ли использование и эффект после launch.
Источники
Хотите, чтобы это работало в вашей компании?
Я вывожу ИИ из презентаций в продакшен — с измеримым результатом. В Instagram напишите ADOÇÃO в комментариях к посту, и я пришлю пошаговый план в директ.